Hoe werkt beslismodel Jev voor softwareteams?
Jev geeft software een keuze met zekerheidsscore. Zo zet je dit beslismodel in voor classificeren, routeren en filteren, met een groot taalmodel erachter.
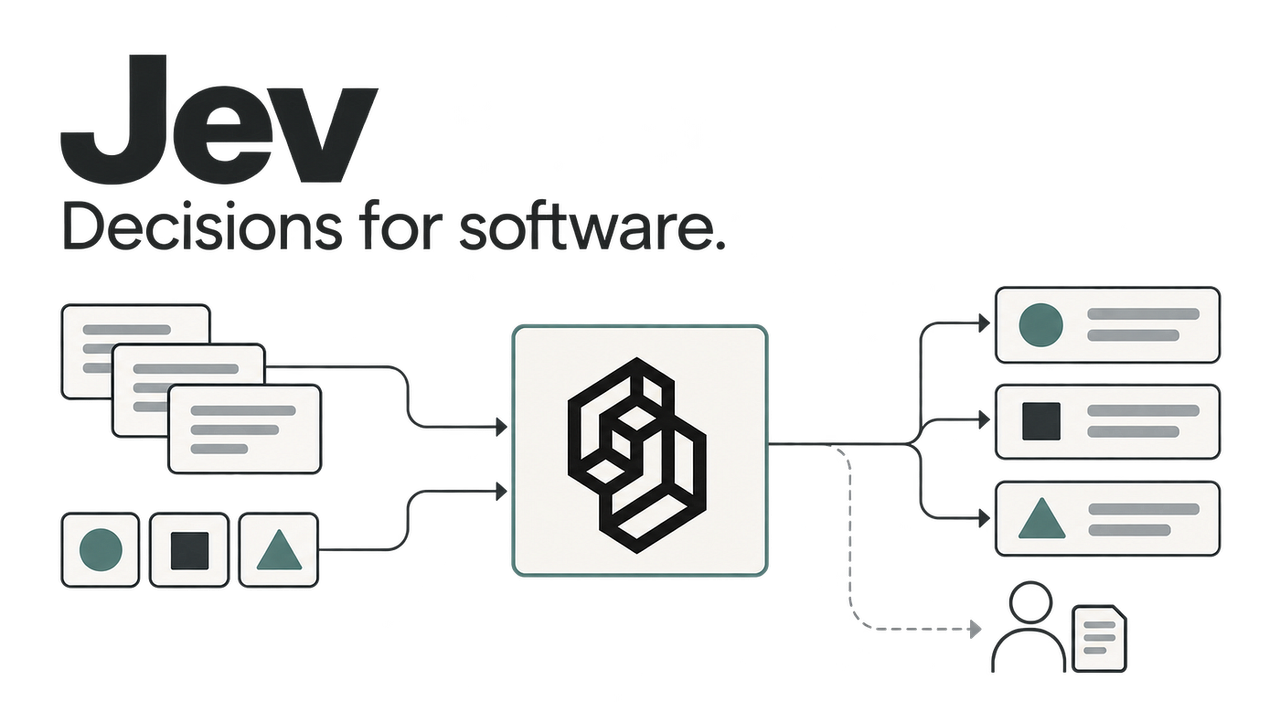
Jev is een AI-model dat software direct een beslissing teruggeeft. Je legt vooraf vast welke antwoorden mogelijk zijn, Jev kiest er een en geeft erbij aan hoe zeker het is. Voor softwareteams zit de waarde in de stappen van een pipeline die eigenlijk alleen een keuze zijn: classificeren, routeren, filteren en groeperen. Die stappen worden met Jev tientallen keren goedkoper en sneller, zonder code om onverwachte antwoorden af te vangen. Het sterkst is Jev als eerste zeef, met een groot taalmodel erachter voor het denkwerk op de selectie die overblijft.
Jev geeft je software een keuze met een zekerheidsscore
Jev komt van TypeSafe AI, het bedrijf van oud-OpenAI-onderzoeker Diogo Almeida. Waarom een van de makers van ChatGPT een model bouwde dat alleen beslist, lees je in ons eerste stuk over Jev. Hier kijken we naar wat het betekent voor wie software bouwt.
Wie nu een taalmodel in een workflow inbouwt, schrijft een prompt, wacht op een geschreven antwoord, haalt daar het label uit en vangt de keren op dat het model iets anders terugstuurt. Jev slaat die tussenstappen over. De uitvoer is altijd een van de opties die je zelf hebt gedefinieerd, met per optie een kans. Een ongeldig antwoord kan niet, dus de code om dat op te vangen vervalt.
Snelheid en prijs doen de rest. Volgens TypeSafe duurt een antwoord 70 tot 500 milliseconden. Invoer kost ongeveer 4 dollarcent per miljoen tokens, uitvoer is gratis.
Welke stappen in je pipeline alleen een beslissing nodig hebben
TypeSafe stelt dat ongeveer 90 procent van wat softwareworkflows nodig hebben een beslissing is. Dat is een claim van de maker zelf. Wie zijn eigen pipelines langsloopt, vindt er wel verrassend veel stappen die neerkomen op een keuze uit een lijstje:
- Classificeren. Is dit ticket een bug, een vraag of een feature request? Welk sentiment heeft deze reactie?
- Routeren. Naar welk team, welke queue of welk vervolgproces gaat dit item?
- Filteren. Is dit relevant genoeg om verder te verwerken, of kan het weg?
- Groeperen. Gaan deze twee items over hetzelfde? Door dat voor veel paren te vragen, bouw je clusters.
- Bewaken. Is deze opdracht veilig, blijft deze agent binnen zijn taak?
Die laatste toepassing draait al in productie. Vercel verving volgens TechCrunch een model van OpenAI door Jev voor het controleren van opdrachten op veiligheid. Dat werd vijf tot achttien keer sneller, met een hogere nauwkeurigheid. Armin Ronacher van Earendil noemt nog een toepassing: per taak voorspellen welk taalmodel nodig is, zodat het dure model alleen draait waar het verschil maakt.
Voor een deel van deze stappen volstaat gewone code met een harde regel. Jev past in het gebied daartussen: te vaag voor een regel, te eenvoudig om een groot model een heel antwoord te laten uitschrijven.
Een beslismodel sorteert, een groot taalmodel denkt na
Het interessantste patroon is de combinatie met een frontier-model. Claire Vo, oprichter van ChatPRD, liet in de podcast How I AI op het netwerk van Lenny Rachitsky zien hoe dat eruitziet. Volgens haar wordt Jev pas echt sterk in combinatie met zo'n groot model.
Haar opzet heeft drie lagen. Jev doet het massawerk: filteren, groeperen, doorsturen. Een klein goedkoop taalmodel zoals Gemini Flash Lite geeft de groepen een leesbare naam. Alleen de belangrijkste groepen gaan naar een frontier-model zoals GPT-6 Astra voor de diepere analyse. In haar grootste proef nam Jev zo 200.000 beslissingen over 1.100 productsignalen. De hele pipeline kostte ongeveer 4 dollar.
Wie een groot taalmodel al die 200.000 beslissingen laat nemen, betaalt topprijs voor werk dat met een ja of nee af is. De taakverdeling maakt het dure denkwerk betaalbaar, omdat het alleen nog draait op wat het verdient.
Softwareteams kunnen hun eigen werk ermee doorlichten
Een voor de hand liggende eerste toepassing ligt in de eigen repository. Vo liet Jev 1.700 pull requests vergelijken in 17.000 paren, op de vraag of twee wijzigingen over hetzelfde soort werk gingen. Uit de clusters bleek binnen twee minuten dat ongeveer 30 procent van het engineeringwerk opging aan platform, beveiliging en infrastructuur. De kosten: 9 dollarcent. Voor een engineeringmanager die moet uitleggen waar de capaciteit heen gaat, is dat een rapport dat je elke sprint opnieuw kunt draaien.
Hetzelfde werkt voor de sessies van codeassistenten als Claude Code en Codex, die lokaal worden bewaard. Jev deelde ze in minuten in naar het soort werk. Zo zie je waar je team AI-assistenten werkelijk voor gebruikt. Bij support- en feedbackdata gaat het net zo: duizenden tickets of reacties in één keer indelen, met een aparte stapel voor de items waar iemand een concreet verzoek doet.
Door de lage wachttijd past Jev ook in realtime toepassingen. In een spraakapp die Vo bouwde, nam Jev zijn beslissingen zo snel dat de externe API voor de rest van de app de vertragende factor werd.
Voor tekst en ontwerp heb je een ander model nodig
Jev kiest en schrijft niet. Documentatie opstellen, code genereren of een interface ontwerpen doe je met een taalmodel. Daarnaast zit Jev nog in early access. De meeste prestatiecijfers komen van TypeSafe zelf en de dienst draait vanuit de Verenigde Staten. Stuur je klantdata door de pipeline, dan speelt onder de AVG de vraag waar die persoonsgegevens terechtkomen. Begin daarom met je eigen engineeringdata of geanonimiseerde feedback.
Bouw de beslisstap als los onderdeel met een vaste interface: invoer, de lijst met opties, een drempel voor de zekerheidsscore. Dan kun je hem vervangen door een regel, een ander beslismodel of een taalmodel zonder de rest van de pipeline aan te passen. Zo blijft je workflow minder afhankelijk van één leverancier, wat verstandig is nu Ronacher snel concurrenten verwacht.
Wekelijkse inzichten in je mail.
Dilemma's, doorbraken en blinde vlekken uit onze AI-praktijk.
Test Jev naast je huidige model op een paar honderd items
Vo vat het zelf samen: de echte vaardigheid is herkennen waar een pipeline alleen een beslissing nodig heeft. Een eerste proef ziet er zo uit.
- Zoek in een bestaande workflow een stap waar een taalmodel een label, categorie of ja/nee teruggeeft.
- Schrijf de mogelijke uitkomsten uit. Betrek iemand die het domein kent, want de kwaliteit van de categorieën bepaalt de kwaliteit van de uitkomst.
- Laat Jev en het huidige model een paar honderd dezelfde items beoordelen en vergelijk nauwkeurigheid, snelheid en kosten.
- Kies een drempel: boven de grens handelt de pipeline het zelf af, daaronder gaat het item naar een mens of een groot model.
Welke stap in jouw workflows laat nu een groot model een heel antwoord schrijven, terwijl je alleen het label gebruikt? Wil je samen uitzoeken waar een beslisstap in jouw pipelines past? Plan een kennismaking in.